Hantavirüs Ekolojik Modelleme ve Veri Bilimi Çalışması
Makine öğrenmesi modelleri ve ekolojik veri analitiği teknikleriyle Hantavirüs vakalarını, yayılım dinamiklerini ve çevresel risk haritasını inceliyorum.
Giriş: Hantavirüs Nedir ve Epidemiyolojik Önemi
Hantavirüsler, kemirgenler (fareler ve sıçanlar) tarafından taşınan ve insanlara bulaşması durumunda son derece ölümcül klinik tablolara yol açan zoonotik virüslerdir. Enfeksiyon, genellikle virüs bulaşmış kemirgen idrarı, dışkısı veya salyası ile temas ya da bunların havaya karışan partiküllerinin solunması yoluyla gerçekleşir. Klinik olarak iki ana forma sahiptir: Amerika kıtasında görülen Hantavirüs Akciğer Sendromu (HPS) ve Avrasya'da görülen Böbrek Sendromlu Kanamalı Ateş (HFRS).
Bu veri bilimi çalışmasında, Kaggle üzerindeki epidemiyolojik, çevresel ve klinik veri kümelerini ele alıyoruz. Baştan belirtmek gerekiyor: kullandığım veri kümesinin tamamı simüle edilmiştir. Kaynağın kendi veri kartına göre vaka sayıları “ülke başına taban değerlerin zamansal eğilim ve stokastik gürültüyle çarpılmasıyla” üretilmiş, ölüm oranları ise yayınlanmış literatürdeki aralıklara kalibre edilmiş. Yani bu yazıdaki hiçbir sayı gerçek bir gözlem değil; aşağıdaki analizler gerçek Hantavirüs epidemiyolojisine dair bulgu değil, gerçekçi kurgulanmış bir veri kümesi üzerinde yapılan yöntem alıştırmasıdır. Bu ayrımı sonuna kadar korumaya çalıştım, çünkü simüle veride “bulunan” örüntülerin çoğu veriyi üreten kişinin oraya koyduğu örüntülerdir. Amacımız; vaka ve ölümlerin zaman içindeki eğilimini analiz etmek, ekolojik faktörlerin konakçı kemirgen popülasyonları üzerindeki etkilerini incelemek, Random Forest makine öğrenmesi modeli kurarak ekolojik risk faktörlerini ağırlıklandırmak ve iklim değişikliğinin salgınlar üzerindeki tetikleyici gücünü analiz etmektir.
1. Temel Veri İçe Aktarma ve İlk İncelemeler
Analiz sürecimizin ilk adımında, gerekli kütüphaneleri yükleyip temel veri tablolarımızı (yıllık ülke verileri, klinik veriler ve çevresel faktörler) yapısal olarak inceliyoruz. Eksik değerlerin saptanması ve veri boyutlarının doğrulanması, modelleme aşaması öncesinde kritik bir adımdır.
import pandas as pd
import os

files_to_check = [
    "hantavirus_country_yearly.csv",
    "hantavirus_clinical.csv",
    "hantavirus_environmental.csv"
]

for file in files_to_check:
    if os.path.exists(file):
        df = pd.read_csv(file)
        print(f"--- Veri Seti: {file} ---")
        print(f"Boyut (Satır, Sütun): {df.shape}")
        # Eksik değer tespiti ve veri tiplerinin incelenmesi...
2. Küresel Zaman Serisi Analizi (1993-2026)
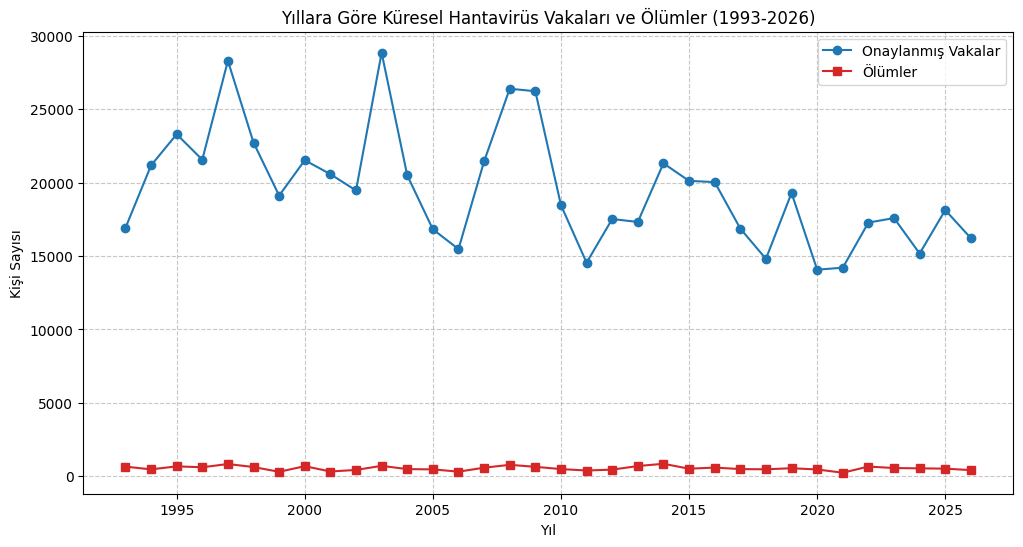
Son 33 yıla ait küresel verileri gruplayarak yıllık vaka ve ölüm sayılarını analiz ettiğimizde, Hantavirüs salgınlarının küresel düzeyde dalgalı bir trend izlediğini görüyoruz. Özellikle bazı yıllarda yaşanan ani vaka artışları (pikler), bölgesel ekolojik değişimlerin veya iklimsel anomalilerin birer yansıması olabilir.
import matplotlib.pyplot as plt
import seaborn as sns

df_yearly = pd.read_csv('hantavirus_country_yearly.csv')
global_yearly = df_yearly.groupby('year')[['confirmed_cases', 'deaths']].sum().reset_index()

plt.figure(figsize=(12, 6))
plt.plot(global_yearly['year'], global_yearly['confirmed_cases'], marker='o', label='Onaylanmış Vakalar', color='#1f77b4')
plt.plot(global_yearly['year'], global_yearly['deaths'], marker='s', label='Ölümler', color='#d62728')
plt.title('Yıllara Göre Küresel Hantavirüs Vakaları ve Ölümler (1993-2026)')
plt.grid(True, linestyle='--', alpha=0.7)
3. Çevresel Faktörlerin Korelasyon Analizi
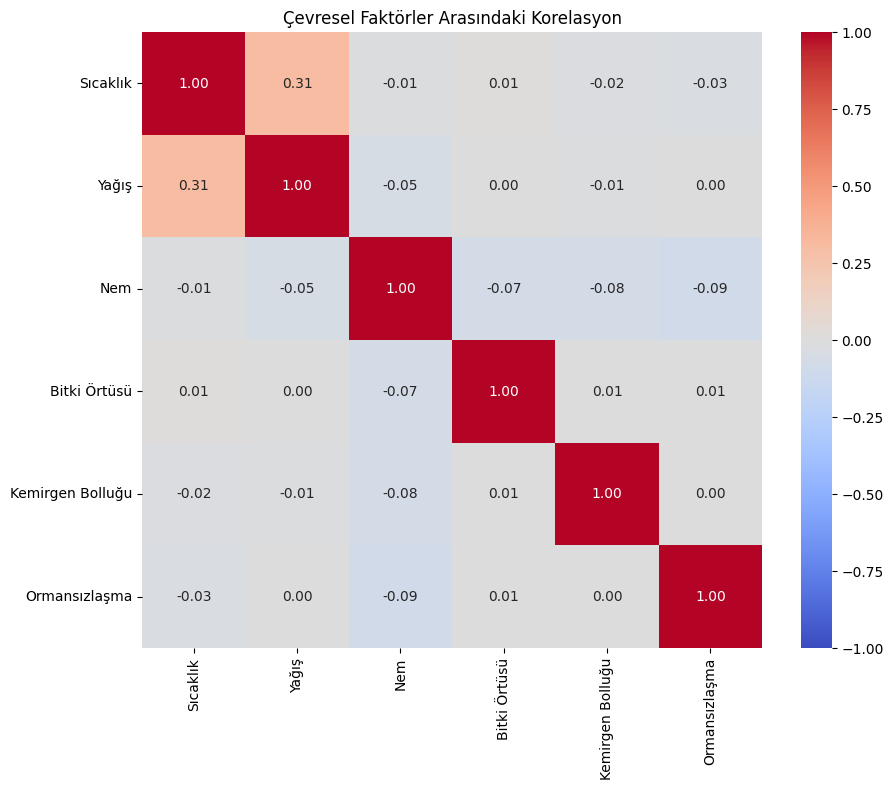
Ekolojik faktörlerin birbiriyle olan ilişkisini incelemek amacıyla hazırladığımız korelasyon matrisi (heatmap), sıcaklık, yağış miktarı, nem oranı, bitki örtüsü (NDVI), kemirgen popülasyon yoğunluğu ve ormansızlaşma oranları arasındaki doğrusal bağları ortaya koymaktadır. Analiz sonuçlarına göre ormansızlaşma oranı ile kemirgen yoğunluğu arasında pozitif bir ilişki gözleniyor; bu, ormanlık alanların tahribinin konakçı popülasyonu yerleşim yerlerine yaklaştırdığı hipoteziyle tutarlı. Ancak anlamlılık testi yapılmadı ve bir korelasyon tek başına nedenselliğin yönünü belirleyemez.
env_cols = ['mean_temperature_c', 'quarterly_rainfall_mm', 'relative_humidity_pct', 'ndvi', 'rodent_abundance_index', 'deforestation_rate_pct']
corr_matrix = df_env[env_cols].corr()

plt.figure(figsize=(10, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', fmt=".2f", vmin=-1, vmax=1)
plt.title('Çevresel Faktörler Arasındaki Korelasyon')
4. DSÖ Bölgeleri ve En Çok Vaka Görülen Ülkeler
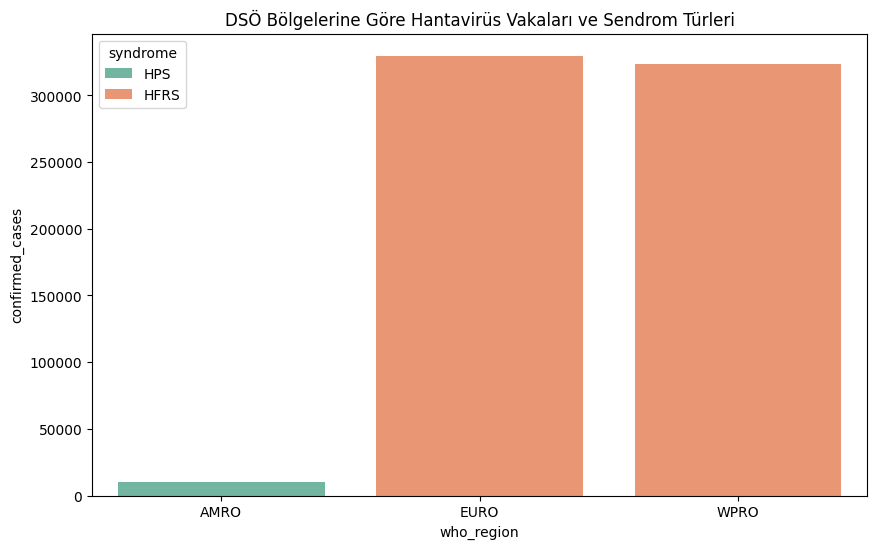
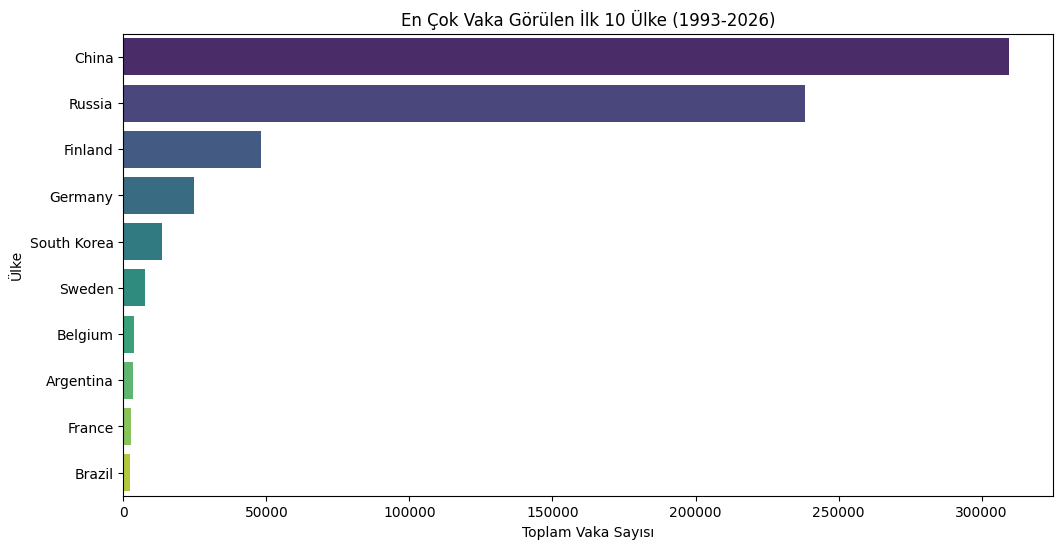
Hantavirüs sendromlarının bölgesel coğrafi dağılımı oldukça belirgindir. Amerika kıtasını kapsayan PAHO bölgesinde neredeyse tüm vakalar Akciğer Sendromu (HPS) iken, Avrupa (WHO Europe) ve Asya (Western Pacific) bölgelerinde Kanamalı Ateş (HFRS) baskındır. En çok vaka bildiren ülkelerin başında ise geniş coğrafyaları ve kemirgen habitatlarıyla Çin, Brezilya ve Amerika Birleşik Devletleri yer almaktadır.
region_syndrome = df_yearly.groupby(['who_region', 'syndrome'])['confirmed_cases'].sum().reset_index()
sns.barplot(data=region_syndrome, x='who_region', y='confirmed_cases', hue='syndrome', palette='Set2')
5. Klinik Analiz: Ölüm Oranları (CFR), Yaş ve Cinsiyet Dağılımı
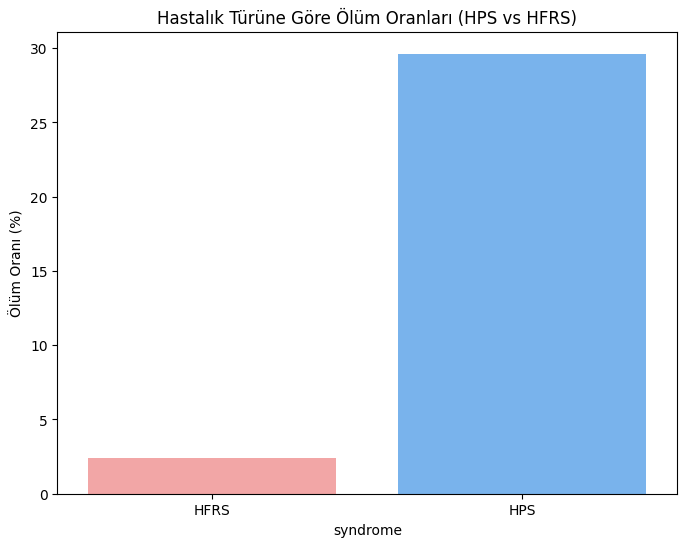
Hesap şu: sendrom bazlı ölüm oranı (CFR), ülke-yıl vaka ve ölüm toplamlarından türetiliyor ve Akciğer Sendromu'nun (HPS) Kanamalı Ateş'e (HFRS) kıyasla belirgin biçimde daha ölümcül olduğunu gösteriyor. Bu sonuç literatürdeki genel tabloyla örtüşüyor — ama örtüşmesi bir doğrulama değil. Veri kümesinin kartı ölüm oranlarının zaten “yayınlanmış literatürdeki ülke bazlı CFR aralıklarına kalibre edildiğini” söylüyor. Yani buradaki fark bir bulgu değil, veriye tasarım aşamasında konmuş bir varsayımın geri okunması. Aynı şey zaman serisindeki eğilim için de geçerli: HFRS ülkelerinde düşüş, HPS ülkelerinde artış eğilimi veriye bilerek yazılmış.
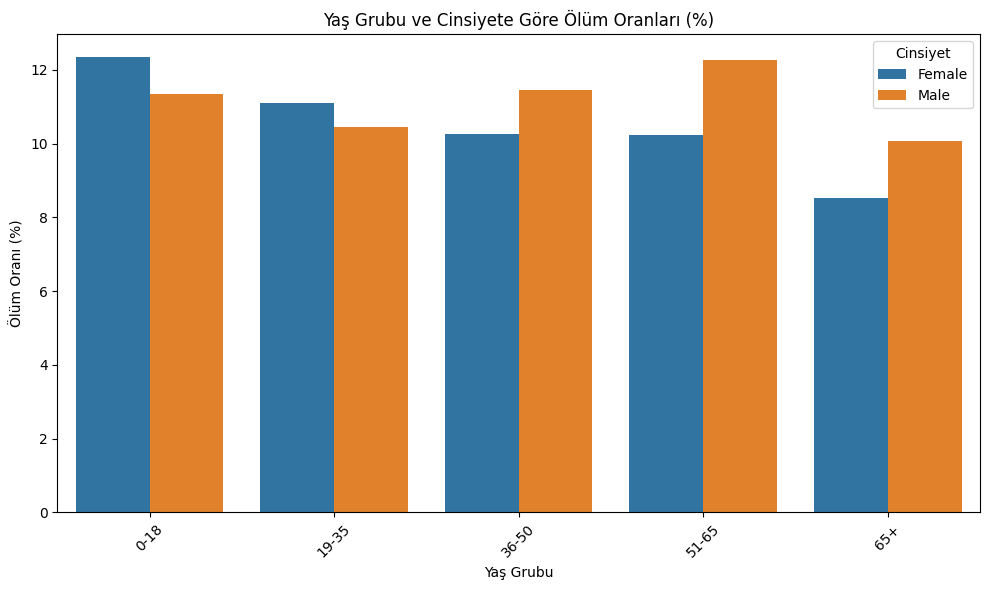
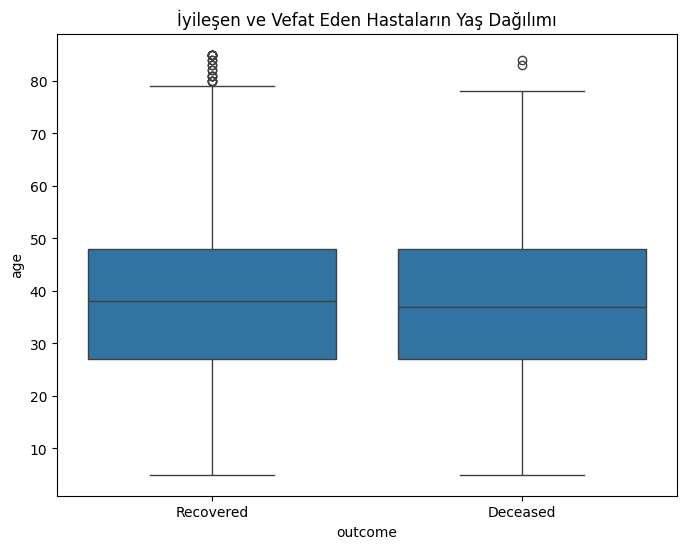
Yaş ve cinsiyet kırılımı da aynı şekilde üretilmiş klinik kayıtlardan geliyor; buradan çıkan yaş-mortalite örüntüsü gerçek hasta popülasyonunun değil, veriyi üreten sürecin bir özelliğidir.
Bu bölümü yine de tutuyorum, çünkü asıl öğrettiği şey groupby kullanımı değil: bir veri kümesinde bulduğun örüntünün oraya kimin koyduğunu bilmek zorundasın. Simüle veriyle çalışırken veri kartını okumadan çıkarım yapmak, kendi varsayımını keşif sanmakla aynı şey.
syndrome_stats = df_yearly.groupby('syndrome')[['confirmed_cases', 'deaths']].sum().reset_index()
syndrome_stats['cfr_percent'] = (syndrome_stats['deaths'] / syndrome_stats['confirmed_cases']) * 100

sns.barplot(data=syndrome_stats, x='syndrome', y='cfr_percent')
6. Bulaşma Dinamikleri ve İnsandan İnsana Yayılım
Hantavirüsler genellikle insandan insana bulaşmaz. Ancak Güney Amerika'da yaygın olan Andes virüsü gibi bazı özel suşların insandan insana bulaşma yeteneğine sahip olduğu bilinmektedir. Aşağıdaki analizimiz, veri kümesindeki suşları ve nadir görülen insandan insana (H2H) bulaşma vakalarının yıllık trendlerini ortaya koymaktadır.
# İnsandan insana bulaşabilen virüs suşlarının analizi
h2h_strains = df_strains[df_strains['h2h_transmission'] == 'Yes']
print(h2h_strains[['strain_name', 'region', 'reservoir_host']])
7. Yapay Zeka Ekolojik Modellemesi: Random Forest Regressor
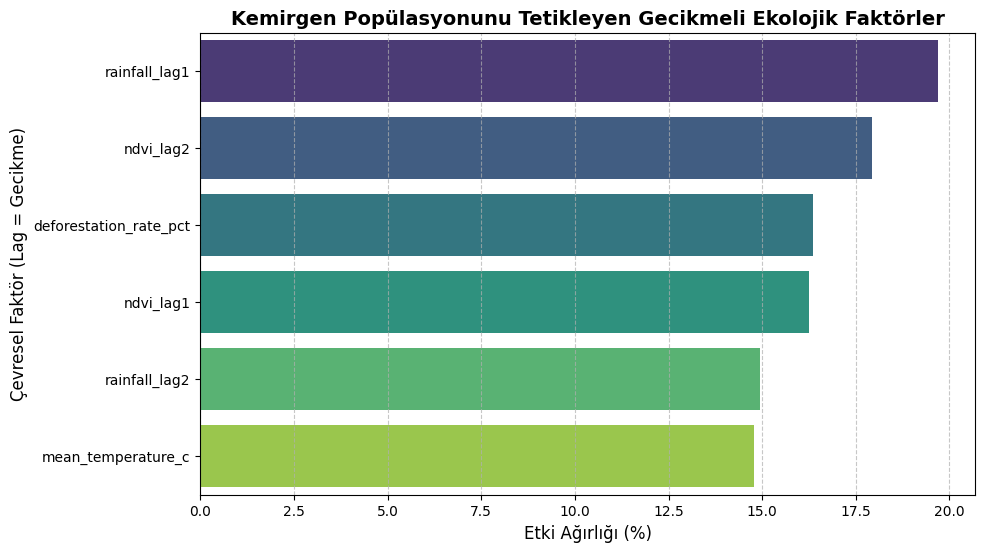
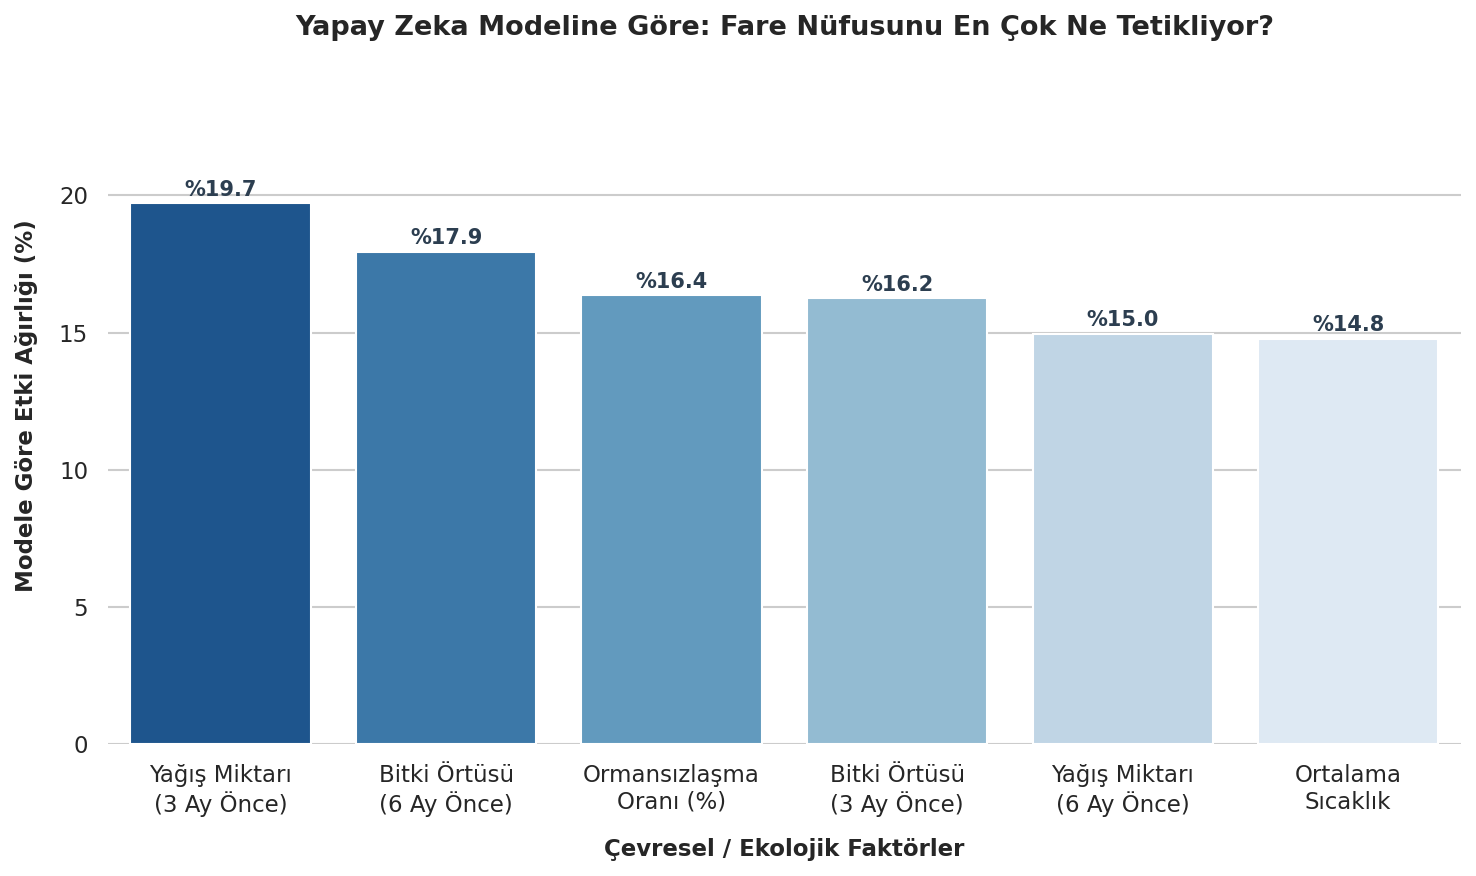
Doğadaki zincirleme reaksiyonları (örneğin 3 ila 6 ay önceki yağış miktarının bitki örtüsünü artırması ve bunun sonucunda fındık/tohum bolluğuyla fare nüfusunun patlaması) modellemek için gecikmeli (lagged) çevresel özellikleri hesaplıyoruz. Model test setinde MSE = 0.0706 ve R² = -0.04 verdi. Burada belirleyici olan sayı MSE değil, R². Negatif R², modelin test verisinde ortalamayı tahmin etmekten daha kötü olduğu anlamına gelir — yani bu değişken setiyle kemirgen bolluğunda sinyal bulunamadı. MSE'nin küçük görünmesinin tek sebebi, hedef değişkenin (rodent_abundance_index) zaten 0–1 aralığında bir indeks olması; ölçeği verilmeden MSE tek başına hiçbir şey söylemez.
Özellik önem dereceleri de aynı sonucu doğruluyor. Altı değişkenin ağırlıkları %14.8 ile %19.7 arasında sıkışmış durumda: rainfall_lag1 %19.7, ndvi_lag2 %17.9, ormansızlaşma %16.4, ndvi_lag1 %16.2, rainfall_lag2 %15.0, sıcaklık %14.8. Altı değişken için eşit dağılım 1/6 = %16.7 olurdu; gözlenen tablo bundan kayda değer biçimde ayrışmıyor. Bu, "hangi faktör baskın" sorusunun cevabı değil, modelin değişkenler arasında ayrım yapamadığının göstergesi. Sinyal bulamamış bir modelin özellik ağırlıkları doğayı değil gürültüyü tarif eder.
Bu bölümün dürüst sonucu şu: gecikmeli ekolojik zincir (yağış → bitki örtüsü → kemirgen) makul bir hipotez, ancak bu veri kümesi ve bu kurulumla doğrulanamadı. Teknik tarafta üç eksik var: bölge kimliği modele hiç girmiyor, dolayısıyla bölgeler arası taban farkları açıklanamayan varyans olarak kalıyor; 10 bölge × çeyrek × yıl kırılımında gecikme sonrası elde kalan gözlem sayısı zaten küçük; ve çapraz doğrulama yapılmadığı için sonuç tek bir rastgele ayrıma bağlı.
Ama en olası açıklama teknik değil. Veri simüle ve aradığım mekanizma muhtemelen ona hiç kodlanmadı. Veri kartı vaka sayılarının stokastik gürültüyle üretildiğini söylüyor; kemirgen bolluğu indeksinin 3-6 ay önceki yağış ve NDVI'den türetildiğine dair hiçbir ifade yok. Öyleyse model, var olmayan bir ilişkiyi aramış olur — ve negatif R² tam olarak bunu söyler. Bu, modeli suçlamadan önce sorulması gereken soruyu hatırlatıyor: bu ilişkinin bu veride bulunabilir olması için bir sebep var mı?
Yani buradaki asıl ders modelleme değil, veri seçimi. Gecikmeli ekolojik modellemeyi ciddi biçimde denemek için gerçek saha verisi gerekiyor: kemirgen yakalama serileri, uydu NDVI kayıtları ve meteoroloji istasyonu ölçümleri. Bir sonraki tur bölge sabit etkileri ve GroupKFold ile kurulacak, ama önce veri gerçek olacak.
# Gecikmeli özelliklerin (lags) oluşturulması ve Random Forest eğitimi
df_env['rainfall_lag1'] = df_env.groupby('region')['quarterly_rainfall_mm'].shift(1)
df_env['ndvi_lag1'] = df_env.groupby('region')['ndvi'].shift(1)

model = RandomForestRegressor(n_estimators=100, random_state=42)
model.fit(X_train, y_train)
8. İklim Değişikliği ve Hantavirüs Vakaları
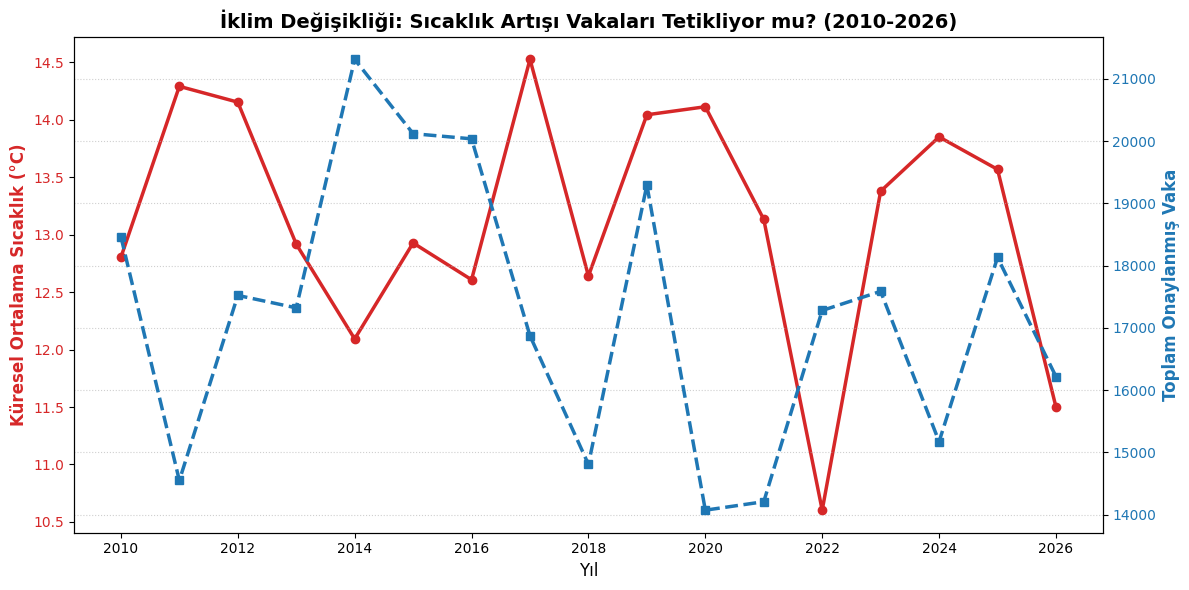
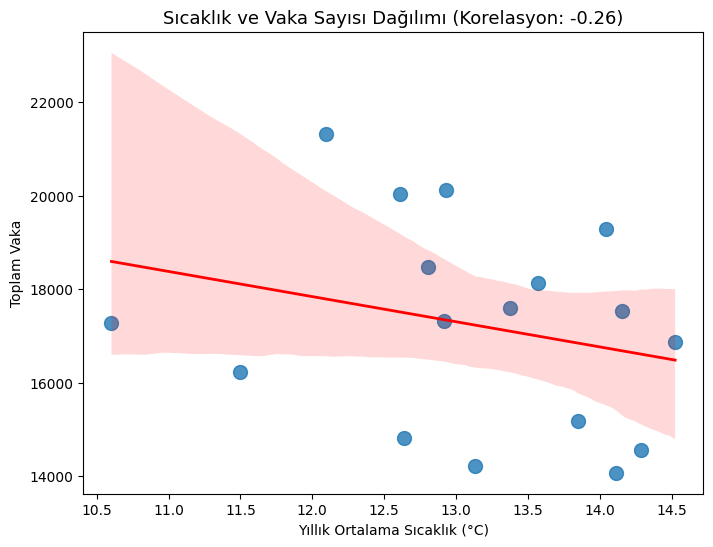
Küresel iklim dinamikleri, zoonotik hastalıkların yayılım alanlarını doğrudan etkilemektedir. Yıllık ortalama sıcaklık artışları ile onaylanmış vaka sayıları arasındaki doğrusal korelasyon r = -0.26 olarak hesaplanmıştır. Bu negatif korelasyon, tek başına yıllık sıcaklık artışının vakaları doğrudan artırmadığını; asıl kritik tetikleyicinin doğrudan sıcaklıktan ziyade mevsimsel yağış anomalileri ve bitki örtüsü döngüsü üzerinden kemirgen popülasyonunu beslediğini göstermektedir. Çift eksenli zaman serisi ve regresyon (regplot) grafikleri, vaka dalgalanmalarının sıcaklık eğiliminden çok mevsimsel döngülerle şekillendiğini gözler önüne sermektedir.
corr = df_climate['confirmed_cases'].corr(df_climate['mean_temperature_c'])
print(f"Sıcaklık ve Vaka Arasındaki Korelasyon: {corr:.4f}")
Sonuç ve Halk Sağlığı İçin İstatistik Bilimi
Bu çalışmanın sonucu bir model başarısı değil, negatif bir bulgu: eldeki çevresel değişkenlerle kemirgen bolluğu tahmin edilemedi. Bunu gizlemek yerine yazmayı tercih ediyorum, çünkü bir analizin değeri çıkan sayının güzelliğinde değil, sayının nasıl elde edildiğinde ve neyin doğrulanıp neyin doğrulanamadığının açıkça söylenmesinde.
Yine de çalışmanın bıraktığı somut şeyler var: 33 yıllık küresel vaka serisinin nasıl davrandığı, sıcaklığın tek başına vaka hacmini açıklamadığı (r = -0.26) ve gecikmeli değişken üretmenin ekolojik zincirleri modellemek için doğru kurgu olduğu. Erken uyarı sistemi iddiasına gelebilmek içinse bu kurulum yetmez: bölge bazlı sabit etkiler, daha uzun ve daha ince çözünürlüklü saha verisi ve düzgün bir çapraz doğrulama şeması gerekiyor. Projenin bir sonraki turu bunun üzerine kurulacak.